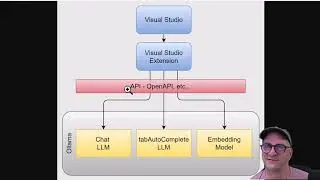
Using local Large Language Models for AI code assist in Visual Studio Code
auf dem Kanal: Joe Freeman: Software Craft, Org Stuff, Tech Stuff
We can run LLM models locally, assuming we have enough VRAM or a big enough MAC, and use those models for Coding assist. No messages have to leave our network and we don't have to worry about unexpected costs due to orphan processes. This can also work for local servers
Windows with NVidia 8GB: https://joe.blog.freemansoft.com/2024...
Mac: https://joe.blog.freemansoft.com/2024...
Windows with NVidia 24GB: https://joe.blog.freemansoft.com/2024...
Auf dieser Seite können Sie das Online-Video Using local Large Language Models for AI code assist in Visual Studio Code mit der Dauer stunde minuten sekunde in guter Qualität ansehen, das der Benutzer Joe Freeman: Software Craft, Org Stuff, Tech Stuff 24 August 2024 hochgeladen hat, den Link mit Freunden und Bekannten teilen, dieses Video wurde auf Youtube bereits 1,601 Mal angesehen und es wurde von 20 den Zuschauern gefallen. Viel Spaß beim Betrachtenden Zuschauern gefallen!