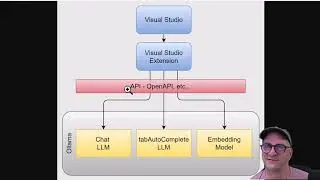
Using local Large Language Models for AI code assist in Visual Studio Code
We can run LLM models locally, assuming we have enough VRAM or a big enough MAC, and use those models for Coding assist. No messages have to leave our network and we don't have to worry about unexpected costs due to orphan processes. This can also work for local servers
Windows with NVidia 8GB: https://joe.blog.freemansoft.com/2024...
Mac: https://joe.blog.freemansoft.com/2024...
Windows with NVidia 24GB: https://joe.blog.freemansoft.com/2024...
На этой странице сайта вы можете посмотреть видео онлайн Using local Large Language Models for AI code assist in Visual Studio Code длительностью часов минут секунд в хорошем качестве, которое загрузил пользователь Joe Freeman: Software Craft, Org Stuff, Tech Stuff 24 Август 2024, поделитесь ссылкой с друзьями и знакомыми, на youtube это видео уже посмотрели 1,601 раз и оно понравилось 20 зрителям. Приятного просмотра!