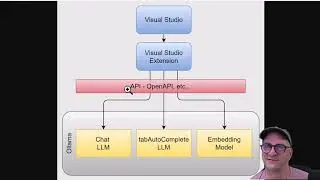
Using local Large Language Models for AI code assist in Visual Studio Code
sul canale di: Joe Freeman: Software Craft, Org Stuff, Tech Stuff
We can run LLM models locally, assuming we have enough VRAM or a big enough MAC, and use those models for Coding assist. No messages have to leave our network and we don't have to worry about unexpected costs due to orphan processes. This can also work for local servers
Windows with NVidia 8GB: https://joe.blog.freemansoft.com/2024...
Mac: https://joe.blog.freemansoft.com/2024...
Windows with NVidia 24GB: https://joe.blog.freemansoft.com/2024...
In questa pagina del sito puoi guardare il video online Using local Large Language Models for AI code assist in Visual Studio Code della durata di ore minuti seconda in buona qualità , che l'utente ha caricato Joe Freeman: Software Craft, Org Stuff, Tech Stuff 24 agosto 2024, condividi il link con amici e conoscenti, su youtube questo video è già stato visto 1,601 volte e gli è piaciuto 20 spettatori. Buona visione!